Tras las grandes promesas del Google I/O 2026, la realidad ha chocado de frente contra los usuarios de pago de la inteligencia artificial de Google. En las últimas semanas, los suscriptores de los planes Pro y Ultra se han encontrado con una desagradable sorpresa al intentar exprimir las capacidades de los nuevos modelos. El cambio silencioso hacia un sistema basado en el consumo de tokens ha desatado una ola de quejas en foros y redes sociales, obligando a la compañía a recular y aplicar parches de emergencia.
Si te has encontrado con el temido aviso de cuota excedida sin haber hecho prácticamente nada, no estás solo. A continuación, desgranamos exactamente qué ha cambiado, por qué ha fallado y qué medidas está tomando Google para solucionarlo.
Qué ha cambiado tras la última actualización
Durante mucho tiempo, los usuarios de Gemini han disfrutado de un sistema predecible basado en un límite fijo de mensajes. Sabías cuántas peticiones podías hacer antes de que el sistema te pidiera esperar. Sin embargo, con el lanzamiento de la nueva generación de herramientas de IA, Google decidió cambiar las reglas del juego.
Del límite de mensajes al consumo por tokens
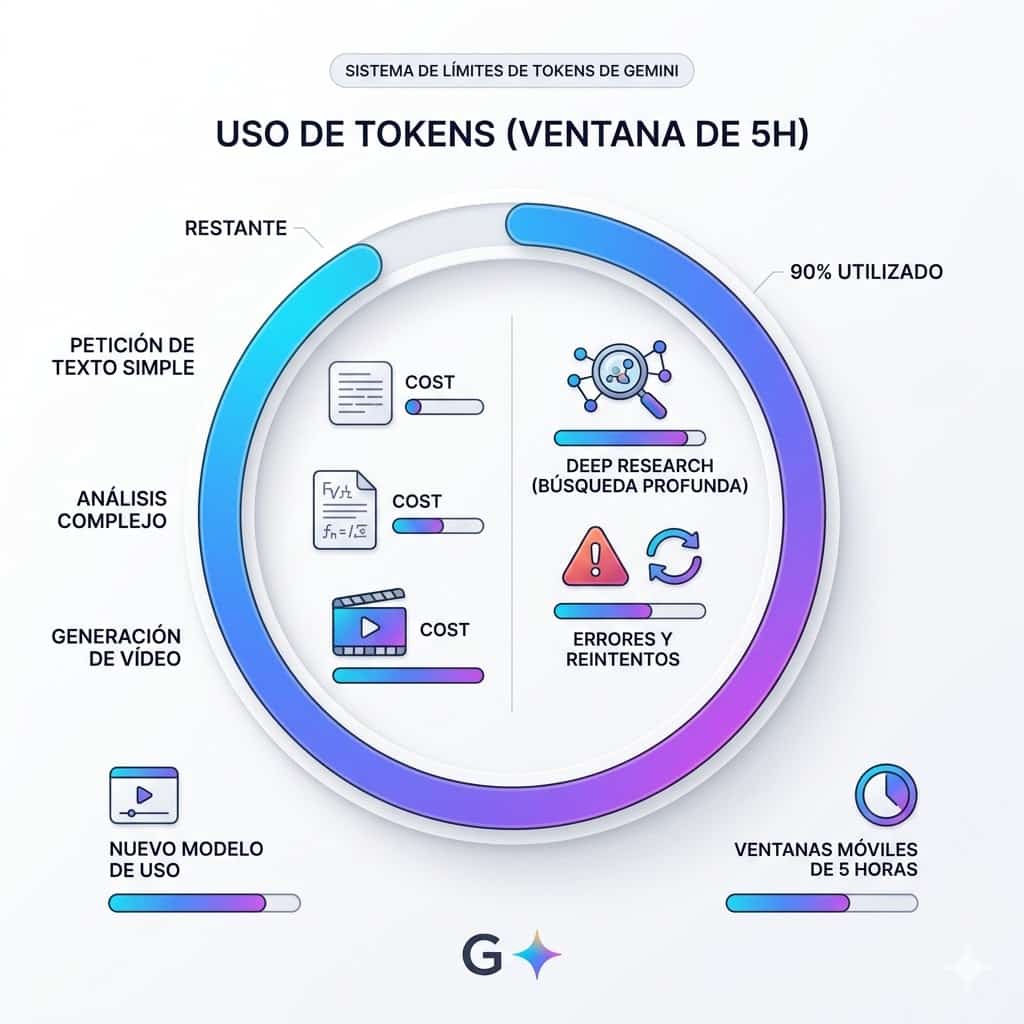
La compañía ha implementado un nuevo modelo de uso basado en el cómputo computacional, es decir, en tokens. Bajo esta nueva arquitectura, el uso se limita en ventanas móviles de cinco horas.
El problema fundamental es que no todas las peticiones cuestan lo mismo. Mientras que una pregunta sencilla consume apenas un puñado de tokens, tareas más pesadas, como la generación de vídeos con el nuevo Gemini Omni o el análisis profundo de documentos masivos (Deep Research), agotan la cuota a una velocidad vertiginosa.
Por qué se quejan los usuarios de pago
La indignación no ha tardado en llegar, especialmente por parte de aquellos usuarios que pagan hasta 250 dólares mensuales por las suscripciones más altas. El cambio se implementó sin la transparencia adecuada, lo que ha provocado situaciones frustrantes en mitad de flujos de trabajo profesionales.
Bloqueos y consumo excesivo en tareas simples
Muchos desarrolladores y creadores han reportado en plataformas como Reddit que sus cuentas quedaban bloqueadas tras realizar apenas un par de acciones. Algunos de los fallos más criticados han sido:
- Penalización por errores: Inicialmente, si Gemini fallaba al intentar generar una respuesta o un vídeo, los tokens consumidos en el intento fallido se descontaban de la cuota del usuario.
- Cargas infinitas: Múltiples reportes indicaban que el sistema se quedaba colgado procesando peticiones, agotando el límite de la ventana de cinco horas sin llegar a ofrecer un resultado útil.
- Bajadas de nivel silenciosas: Al alcanzar el límite, el sistema redirigía a los usuarios al modelo inferior (Gemini 3.1 Flash Lite) sin avisar claramente, rompiendo por completo los flujos de trabajo de quienes necesitaban código o respuestas complejas.
La respuesta oficial de Google
Ante la crisis de reputación y la amenaza de migración masiva hacia alternativas como Claude o ChatGPT, Google ha tenido que intervenir rápidamente. Josh Woodward, vicepresidente responsable de Gemini, emitió un comunicado confirmando que la empresa está realizando ajustes inmediatos basados en el feedback de la comunidad.
Soluciones de emergencia y ajustes en el sistema
Para frenar la sangría de críticas, Google ha confirmado la implementación de varias medidas correctivas que ya se están desplegando en todas las cuentas:
- Límite máximo por petición (Cap): Se ha establecido un tope en la cantidad de cuota que puede consumir un solo prompt. De este modo, una orden extremadamente compleja o un bug interno (como el descubierto en la generación de vídeo) no dejará a cero tu cuenta de forma instantánea.
- Devolución por fallos: A partir de ahora, las peticiones que resulten en error o que no logren completarse con éxito no descontarán tokens de tu asignación. Solo se contabilizarán las tareas finalizadas correctamente.
- Desglose de consumo transparente: La interfaz integrará un panel detallado para que los usuarios puedan auditar en qué tareas exactas están gastando sus tokens.
- Uso gratuito de modelos ligeros: Las peticiones realizadas a los modelos más básicos, como Flash y Lite, dejarán de contar para el límite global, permitiendo un uso más intensivo para tareas cotidianas sin sacrificar la cuota reservada para el modelo Pro.
La transición hacia una IA más potente y autónoma tiene un coste computacional inmenso. Aunque Google está intentando equilibrar sus gastos internos sin asfixiar a sus clientes, este tropezón demuestra que la gestión de expectativas y la transparencia son tan importantes como el propio modelo de inteligencia artificial.