El mundo de la inteligencia artificial ha dependido tradicionalmente de un mantra: cuantos más datos centralizados, mejor. Para que un teclado predictivo sepa qué vas a escribir, o para que una aplicación de fotos reconozca caras, tus datos solían viajar a servidores gigantescos para entrenar a los modelos. Esto, naturalmente, genera enormes preocupaciones sobre la privacidad.
Aquí es donde entra en juego el aprendizaje federado (Federated Learning), un cambio de paradigma que promete una IA más inteligente sin comprometer la seguridad de nuestra información personal. En este artículo explicaremos en qué consiste esta tecnología y por qué está marcando el futuro del desarrollo de software.
¿Qué es exactamente el aprendizaje federado?
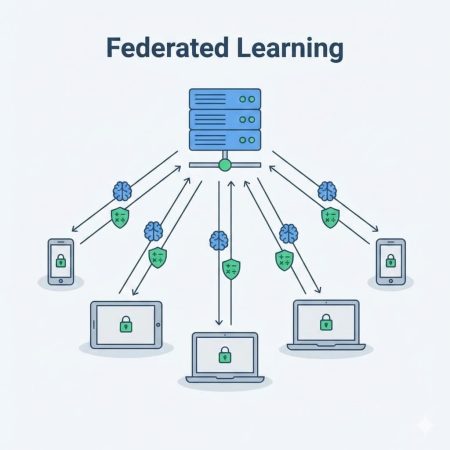
El aprendizaje federado es una técnica de machine learning descentralizado. Su premisa fundamental es darle la vuelta al modelo tradicional: en lugar de enviar los datos de los usuarios a un servidor central para entrenar a la IA, el aprendizaje federado envía el modelo de IA a los dispositivos de los usuarios.
Imagina que tienes un chef maestro (el servidor central) que quiere mejorar una receta. En el modelo tradicional, todos los cocineros del mundo le envían sus ingredientes crudos para que él experimente. En el modelo federado, el chef maestro envía la receta actual a todos los cocineros. Cada cocinero prueba la receta en su propia cocina (tu smartphone), hace pequeñas mejoras basándose en sus ingredientes locales (tus datos), y solo envía de vuelta al chef maestro las notas sobre las mejoras, nunca los ingredientes.
El objetivo principal es entrenar un algoritmo de alta calidad a través de múltiples dispositivos descentralizados manteniendo los datos locales privados y seguros.
Cómo funciona el proceso paso a paso
El proceso de aprendizaje federado es ingenioso y se basa en la colaboración sin exposición de datos brutos. Funciona, a grandes rasgos, en cuatro etapas cíclicas:
- Distribución del modelo: Un servidor central tiene un modelo de IA genérico. Envía una copia de este modelo actual a miles o millones de dispositivos de usuarios (como teléfonos móviles o dispositivos IoT).
- Entrenamiento local: Tu dispositivo utiliza tus datos locales (historial de escritura, fotos, uso de apps) para reentrenar y mejorar ligeramente esa copia del modelo. Este proceso ocurre en tu propio hardware, generalmente cuando el dispositivo está cargando y conectado a Wi-Fi para no afectar el rendimiento.
- Envío de actualizaciones (no de datos): Esta es la clave. Tu dispositivo no envía tus fotos ni tus textos al servidor. Solo envía un pequeño paquete de información matemática (llamado gradientes o pesos) que resume cómo ha mejorado el modelo.
- Agregación central: El servidor central recibe estas pequeñas actualizaciones de millones de dispositivos, las promedia y actualiza el modelo maestro. El nuevo modelo mejorado se vuelve a enviar a los dispositivos, reiniciando el ciclo.
Diferencias clave con el machine learning tradicional
Para entender la magnitud de este cambio, es vital compararlo con la forma clásica de construir inteligencia artificial.
Machine learning tradicional:
- Requiere la centralización masiva de datos en servidores.
- Tus datos personales abandonan tu dispositivo.
- Altos costes de almacenamiento y ancho de banda para las empresas.
- Riesgo de seguridad elevado: si el servidor central es hackeado, todos los datos están expuestos.
Aprendizaje federado:
- Los datos permanecen siempre en el dispositivo del usuario (procesamiento local).
- Solo se comparten parámetros matemáticos anónimos.
- Reduce la necesidad de super servidores de almacenamiento.
- Privacidad por diseño: riesgo de fuga de datos personales drásticamente reducido.
Aplicaciones reales y el futuro
El ejemplo más famoso de aprendizaje federado es el teclado Gboard de Google. Cuando te sugiere la siguiente palabra o corrige tu ortografía de forma personalizada, ha aprendido de tu forma de escribir directamente en tu teléfono, sin enviar todo lo que tecleas a Google.
Otro campo prometedor es la medicina. Diferentes hospitales podrían colaborar para entrenar un modelo de IA que detecte enfermedades en radiografías sin necesidad de compartir los historiales médicos confidenciales de los pacientes entre instituciones. El modelo viaja, los datos sensibles no.
El aprendizaje federado representa un equilibrio necesario entre la innovación tecnológica y el derecho fundamental a la privacidad de los datos, permitiendo que la IA se vuelva más inteligente gracias a nuestra información, pero sin poseerla.